主页 / 论文
论文
加粗为本人;* 表示共同第一作者。点击图片可放大。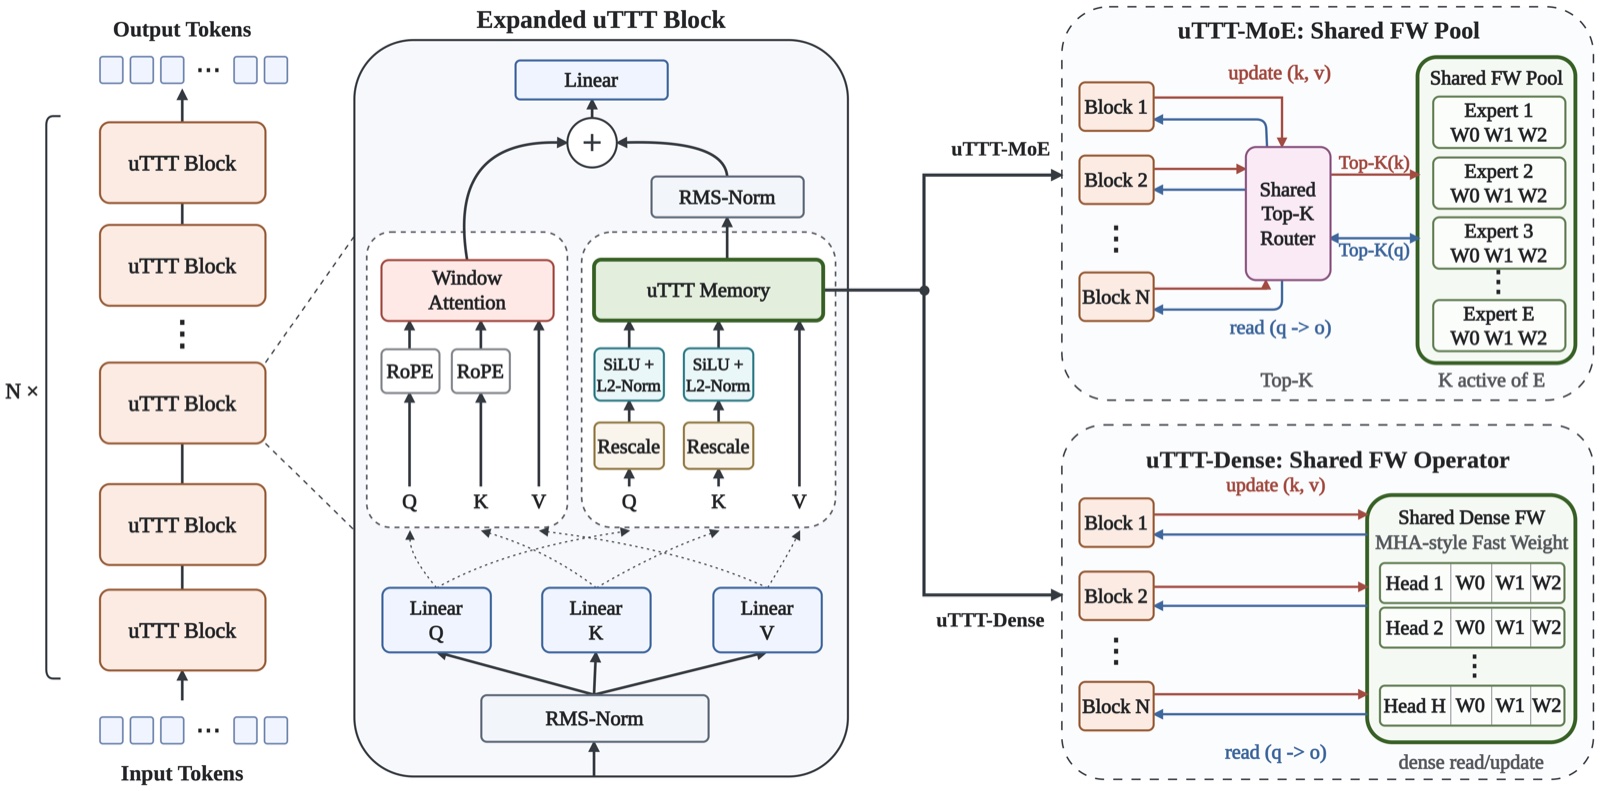
Universal Test-Time Training
* 共同第一作者
COLM 2026 Efficient Reasoning Workshop SpotlightICLR 2027 审稿中
把测试时训练的快权重在所有层之间共享,而不是每层各存一份私有状态;模型因此把时间与深度统一成一个递归,并在相同状态规模下同时提升长上下文检索与新视角合成。
Universal Test-Time Training 架构图:展开的 uTTT 块,以及跨块共享的快权重专家池(uTTT-MoE)或共享稠密快权重算子(uTTT-Dense)。
Test-Time Generation
Zefan Cai,Qinzhe Hu,Yuchen Zhu,Hao Tan,Tianyuan Zhang,Sai Bi,Haoyi Qiu,Yicong Hong,Haozhe Zhao,Jason Kuen,Haoliang Wang,Ruiyi Zhang,Ryan A. Rossi,Wanrong Zhu,Molei Tao,Wen Xiao,Junjie Hu,Jiuxiang Gu ICLR 2027 审稿中
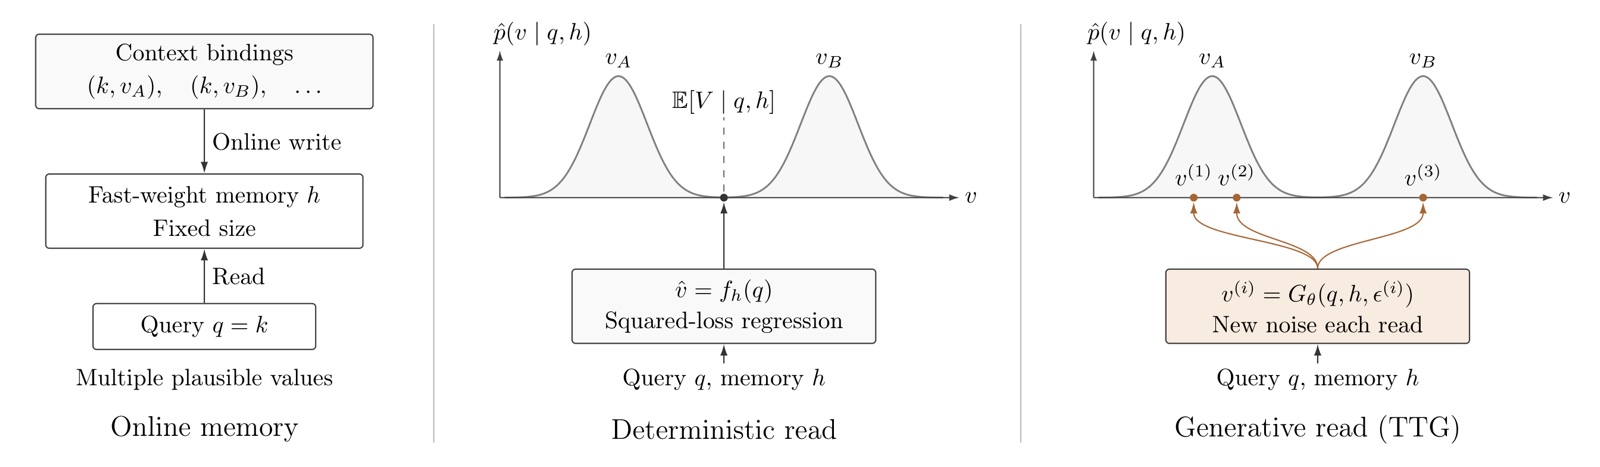
用生成而不是回归到单一答案的方式读取快权重记忆,使同一个 key 存过多个值时,记忆能分别召回它们而不是取平均,在相同状态规模下提升长上下文检索与新视角合成。
快权重记忆的确定性读取与生成式读取对比:平方损失下的读取返回条件均值,可能落在两个合理值之间;生成式读取则采样其中之一。
Last Layer KV Cache is All You Need
ICLR 2027 审稿中
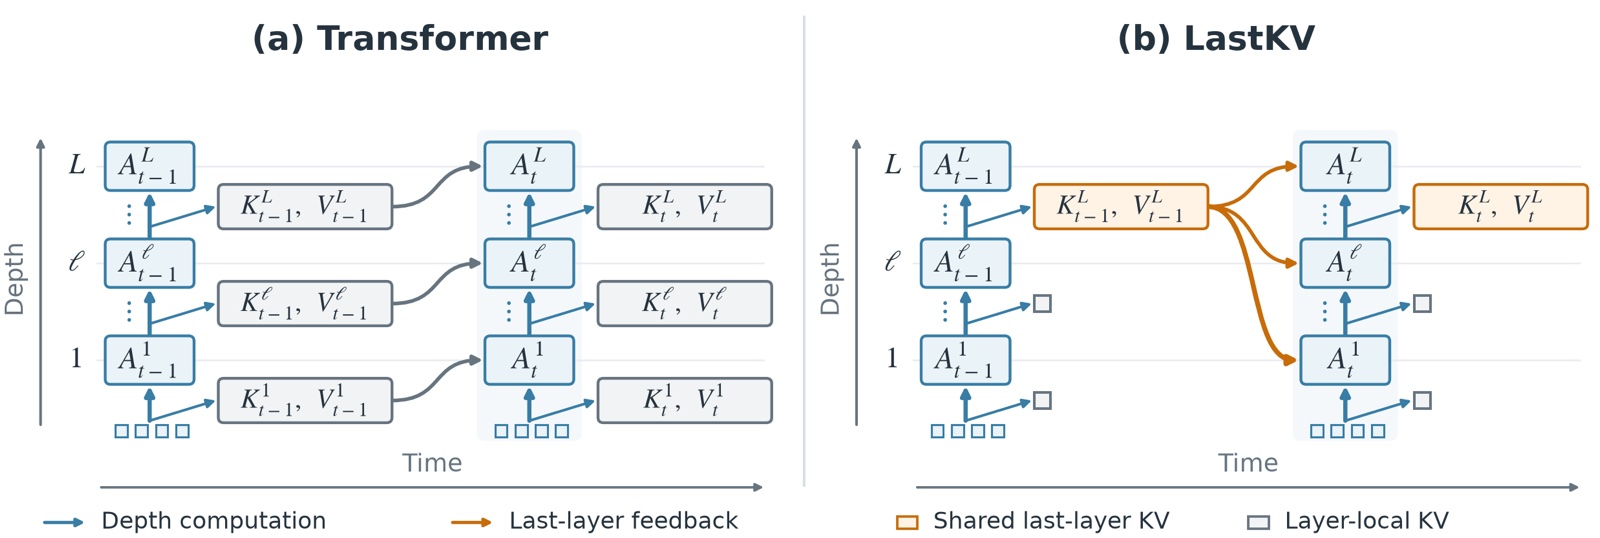
让每一层都读取之前分块的最后一层 KV cache,从而在注意力上把时间与深度统一成一个递归。长期 KV 存储压缩到大约一层的规模,却仍在语言建模、新视角合成和视频生成上持平或超过标准 Transformer,并在长上下文检索和大多数状态追踪任务上领先所比较的各类架构。
Transformer 与 LastKV 对比:标准 Transformer 每层保存各自的 KV 历史;LastKV 只保留已完成分块的最后一层 KV,并让后续分块的每一层读取它。
TF-MoE: Time-Frequency Mixture-of-Experts for Efficient Speech Separation
INTERSPEECH 2026 Oral
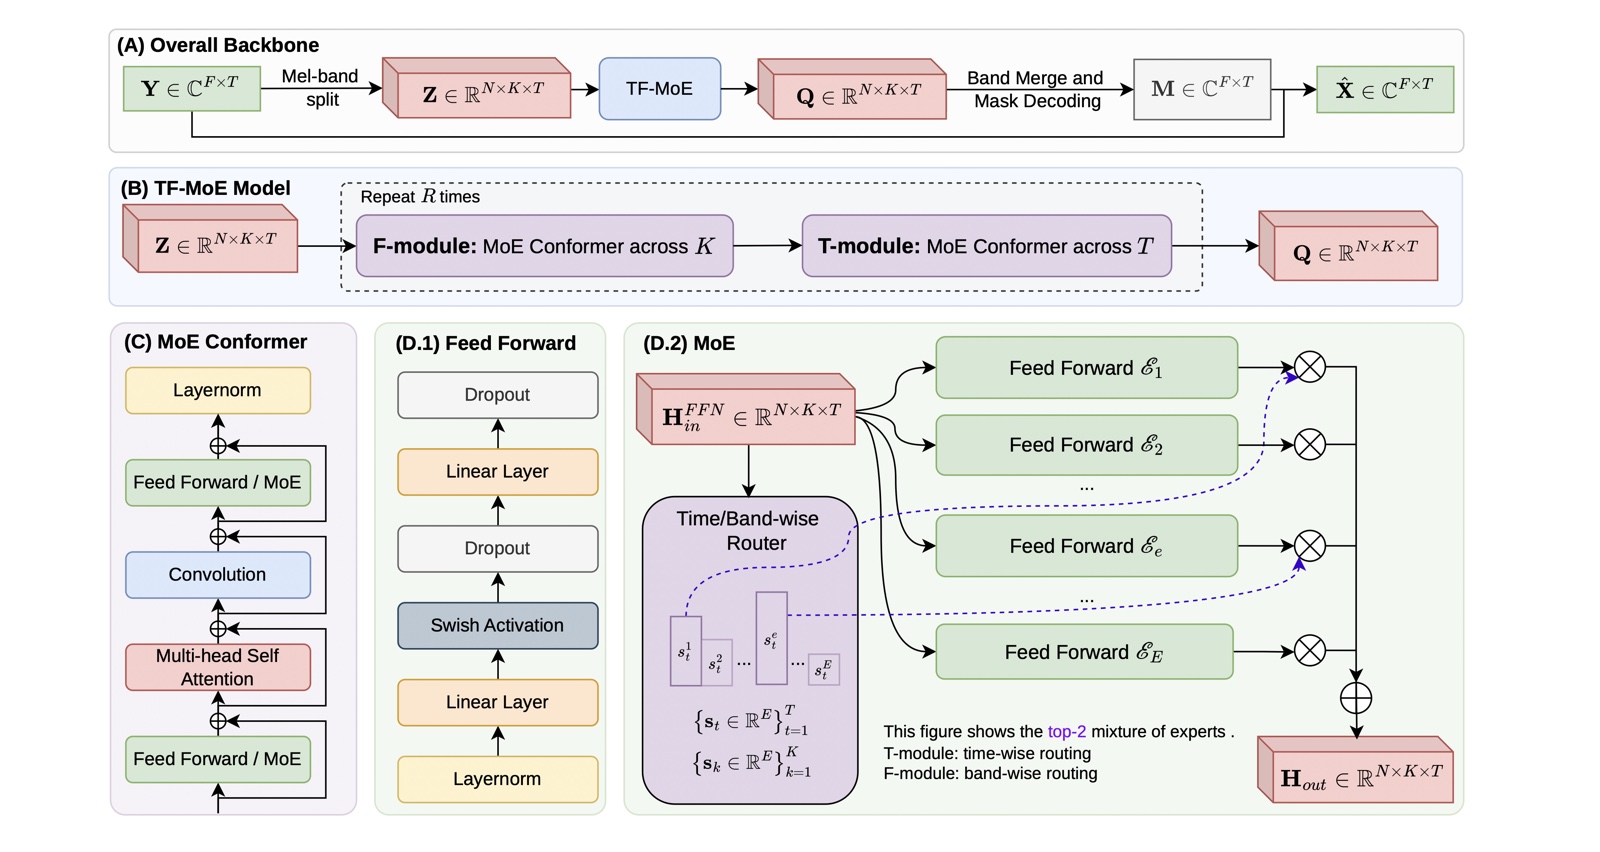
在时间帧和梅尔频带两个维度上稀疏路由专家的混合专家框架,几乎不增加推理开销就能提升语音分离模型的容量,效果超过计算量大得多的模型。
TF-MoE 总览:梅尔子带切分的 Conformer 骨干、交替的频率维与时间维 MoE Conformer 块,以及带时间/子带路由器的稀疏 MoE 前馈模块。
SmartThinker: Progressive Chain-of-Thought Length Calibration for Efficient Large Language Model Reasoning
ICML 2026
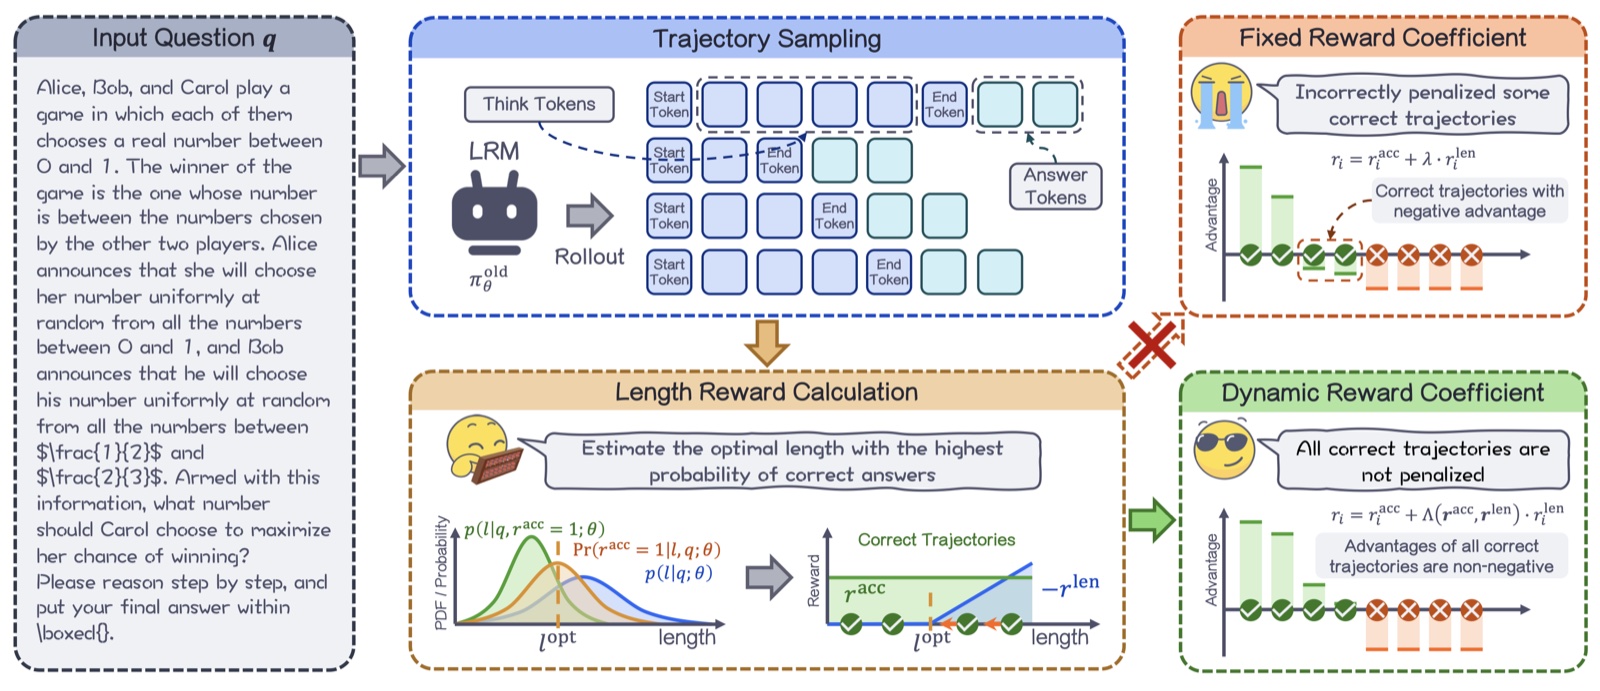
一种面向高效推理的强化学习方法,让模型对每道题只思考必要的长度:训练中为每道题估计最优推理长度,并把过长的回答拉向这个长度,在 AIME25 等基准上最多把推理长度减半,同时提升准确率。
SmartThinker 优势计算流程:轨迹采样、按估计的最优长度计算长度奖励,以及不惩罚正确轨迹的动态奖励系数。