关于我
我是上海交通大学计算机科学与技术专业的大四本科生(ACM 班,致远学院),目前在威斯康星大学麦迪逊分校 HuLab 做研究实习,导师是 Junjie Hu 教授。在交大,我在先进网络实验室由刘生钟教授和吴帆教授指导;此前我曾在 Audiocc 实习,由李晨达教授和钱彦旻教授指导。朋友们叫我 Hugo。
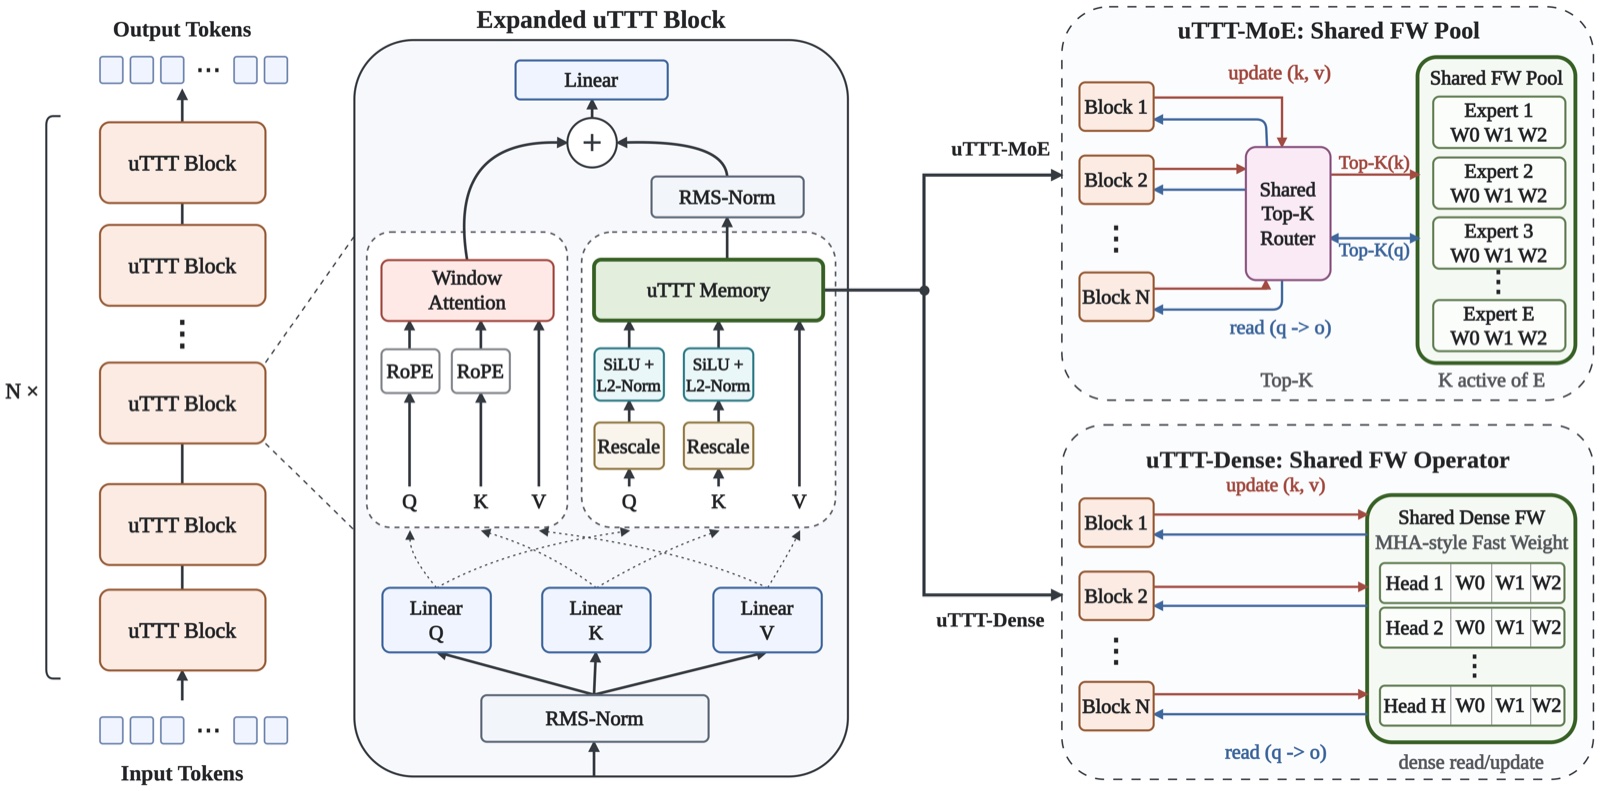
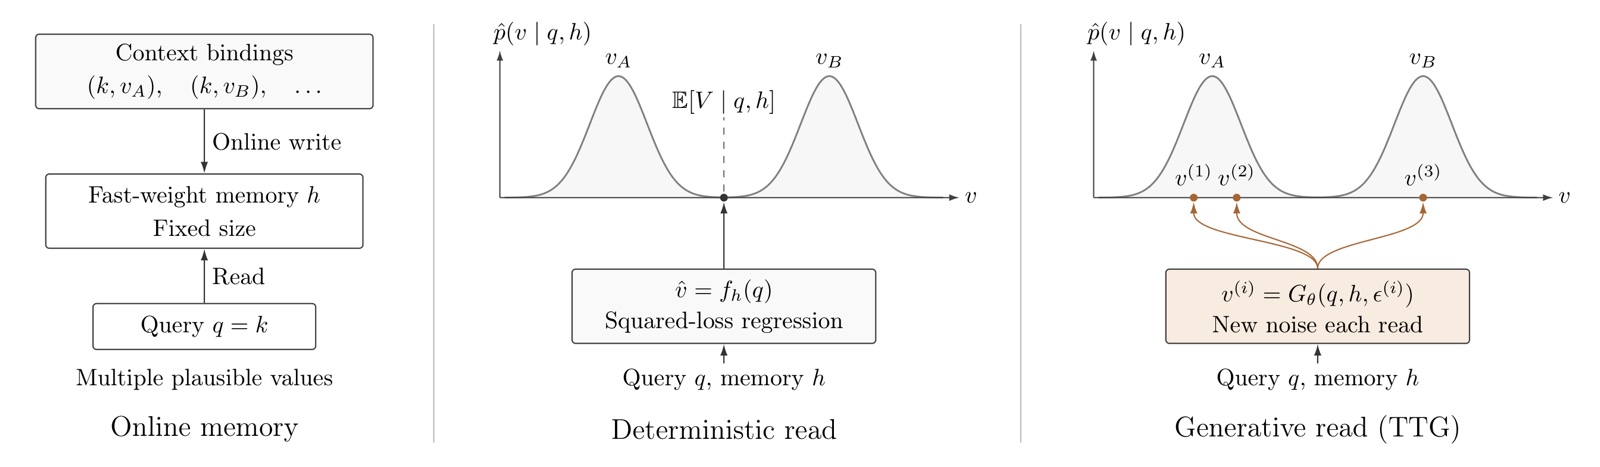
我的研究方向是测试时训练与模型架构,尤其是模型如何在长上下文中存储和读取记忆。在存储上,大多数深层模型让每一层沿时间各存一份记忆,时间和深度彼此分开;我目前的工作把两者统一成一个递归:在 uTTT 中所有层共享一份快权重状态,在 LastKV 中所有层共享一份末层 KV 历史。在读取上,TTG 用生成代替回归来读取快权重记忆。此外,我也做过面向高效推理的强化学习后训练(SmartThinker,ICML 2026)和语音分离中的稀疏专家混合(TF-MoE,INTERSPEECH 2026 Oral)。
我始终欢迎合作与学术讨论。欢迎通过邮件 hugo0713@sjtu.edu.cn 或 qhu99@wisc.edu 联系我,也可以加微信(ID:HUGO--2025)。
我计划申请 2027 年秋季入学的博士项目。
研究方向
- 测试时训练与快权重记忆
- 统一时间与深度的递归
- 跨语言与视觉的长上下文建模
动态
- 🎉 Universal Test-Time Training 被 COLM 2026 Efficient Reasoning Workshop 接收为 Spotlight。
- 🎉 TF-MoE 被 INTERSPEECH 2026 接收为 Oral。
- 🎉 SmartThinker 被 ICML 2026 接收。
- 加入威斯康星大学麦迪逊分校 HuLab 做研究实习,导师 Junjie Hu 教授。
- 加入上海交通大学先进网络实验室,导师刘生钟教授、吴帆教授。
- 🏆 团队项目 JEDI(AI 参会者)在新加坡国立大学计算机学院 2025 暑期学校的云计算课程中获一等奖。
- 加入上海交通大学 Audiocc 实验室做研究实习,导师李晨达教授、钱彦旻教授。
- 进入上海交通大学 ACM 班。
论文 完整列表 →
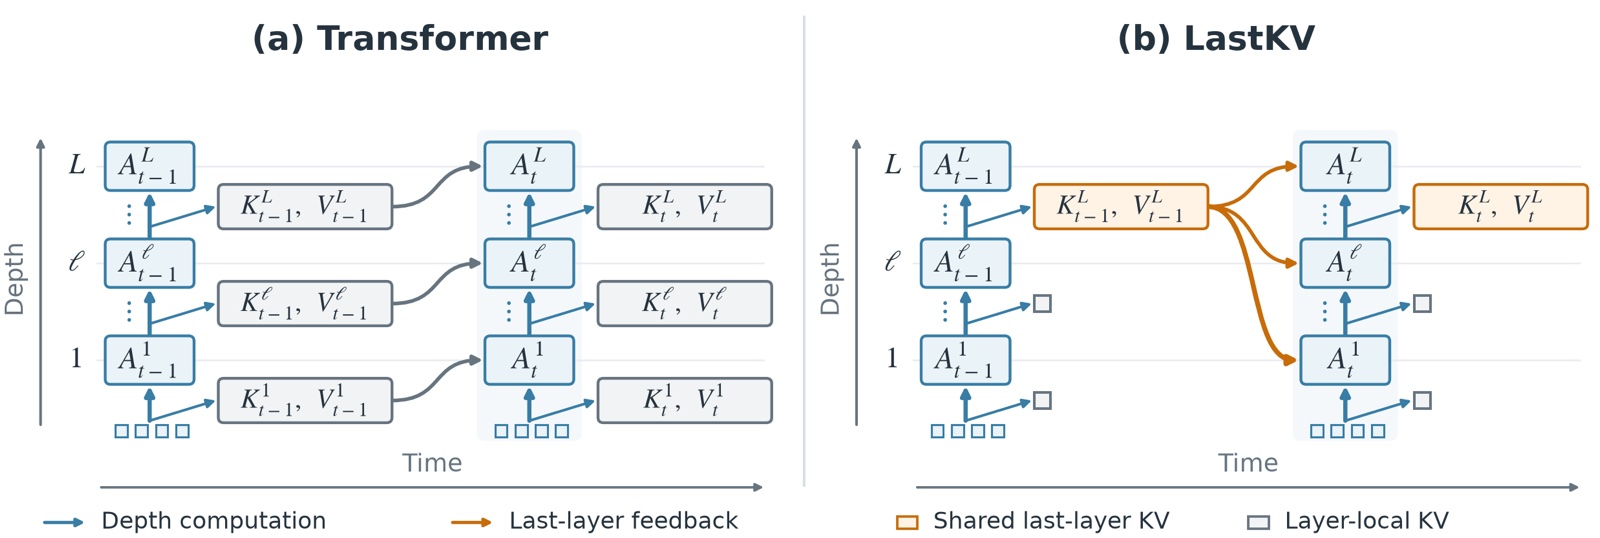
Last Layer KV Cache is All You Need
ICLR 2027 审稿中
让每一层都读取之前分块的最后一层 KV cache,从而在注意力上把时间与深度统一成一个递归。长期 KV 存储压缩到大约一层的规模,却仍在语言建模、新视角合成和视频生成上持平或超过标准 Transformer,并在长上下文检索和大多数状态追踪任务上领先所比较的各类架构。
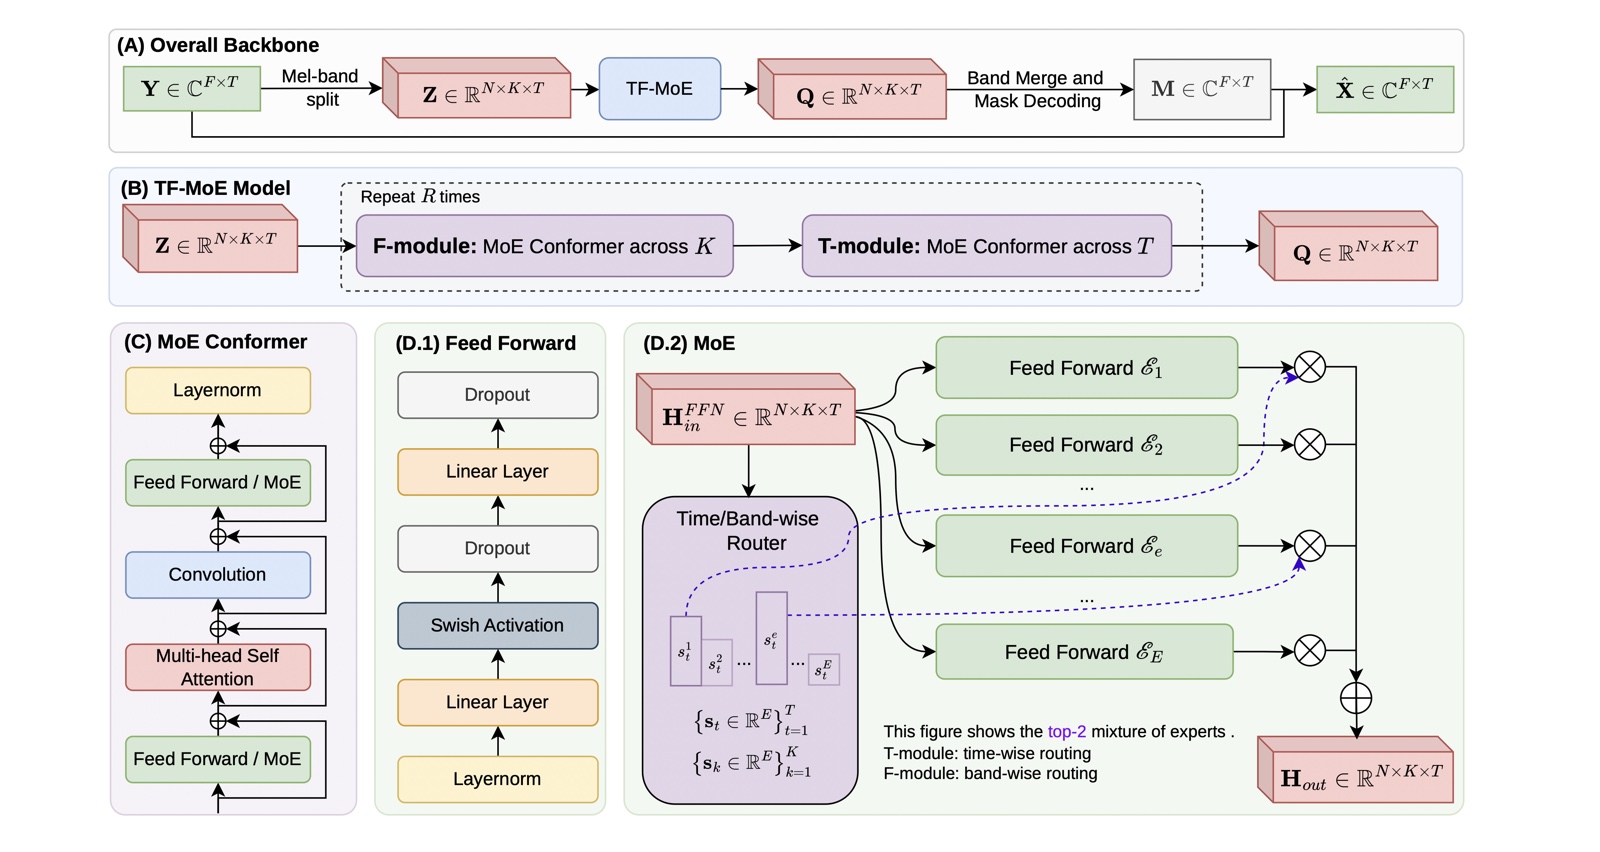
TF-MoE: Time-Frequency Mixture-of-Experts for Efficient Speech Separation
INTERSPEECH 2026 Oral
在时间帧和梅尔频带两个维度上稀疏路由专家的混合专家框架,几乎不增加推理开销就能提升语音分离模型的容量,效果超过计算量大得多的模型。
研究经历
- 威斯康星大学麦迪逊分校 HuLab2026 年 2 月至今研究实习生,导师 Junjie Hu 教授美国麦迪逊 · 2026 年 7 月起驻校
三项关于长上下文记忆的工作,均在 ICLR 2027 审稿中。uTTT 共同一作:让所有层共享一份快权重记忆;TTG 二作:为快权重记忆设计生成式的读取方式;LastKV 合作者:让所有层共享一份末层 KV 历史,把长期 KV 存储压到大约一层的规模,同时提升状态追踪能力。
- 上海交通大学 先进网络实验室2025 年 8 月至今
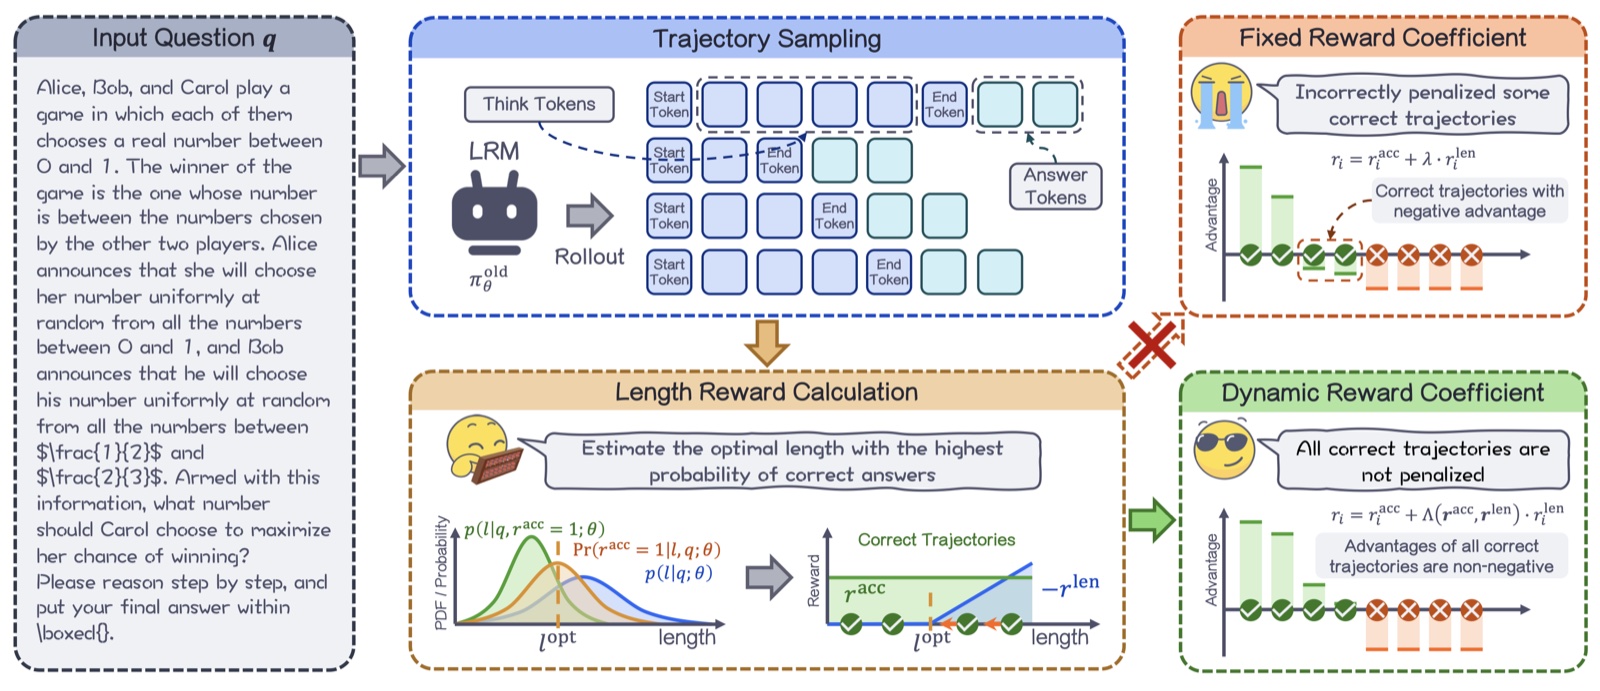
面向高效大模型推理的强化学习与后训练,包括思维链压缩和在线策略蒸馏。
- 新加坡国立大学计算机学院2025 年 5 月 – 7 月云计算方向暑期项目,导师 Richard T. B. Ma 教授新加坡
共同构建 JEDI——能加入 Jitsi 会议并判断何时发言的 AI 参会者;负责其 Kubernetes 原生数据层。
通过在时间帧和梅尔频带上稀疏路由的混合专家,在不缩减容量的前提下降低语音分离模型的运行成本。
教育经历
荣誉
- 致远荣誉奖学金(上海交通大学前 5%)
学术服务
- 审稿人:COLM 2026、ICLR 2027
最近的笔记
课程笔记与研究笔记,中文写作。